

AMD展現Enterprise AI軟體實力 實機展示企業級模型部署與GPU資源管理
- 張姝寧/台北
-

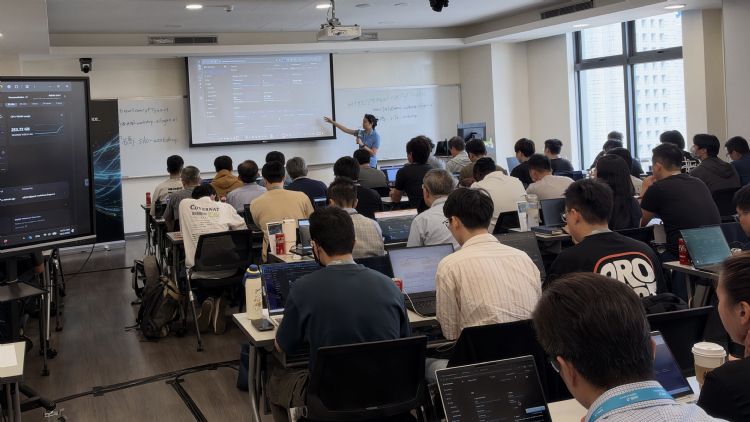
生成式AI加速進入企業應用,市場關注焦點也由GPU算力延伸至模型部署、資源管理與應用整合。企業取得運算資源後,如何將模型導入既有IT環境並轉化為實際應用,成為AI落地的下一道課題。AMD近日在台舉辦首場Enterprise AI Workshop,透過實機操作展示模型部署、效能測試、模型微調、GPU資源管理及AI應用建置等流程,呈現其企業AI布局由GPU與基礎軟體向實際部署環境延伸。
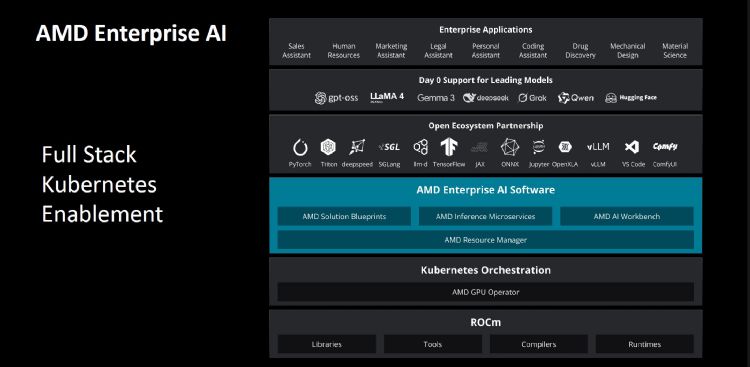
模型推論、開發工具、Kubernetes工作負載調度、GPU資源配置與應用整合等需求,AMD透過Enterprise AI軟體套件,提供涵蓋模型推論、開發部署、工作負載管理與GPU資源管理的企業AI參考架構。其中,AMD Enterprise AI 軟體套件涵蓋AMD Solution Blueprints、AMD Inference Microservices(AIMs)、AMD AI Workbench及AMD Resource Manager,分別對應應用建置、模型推論、開發部署與GPU資源管理,串接模型、軟體與底層運算資源。
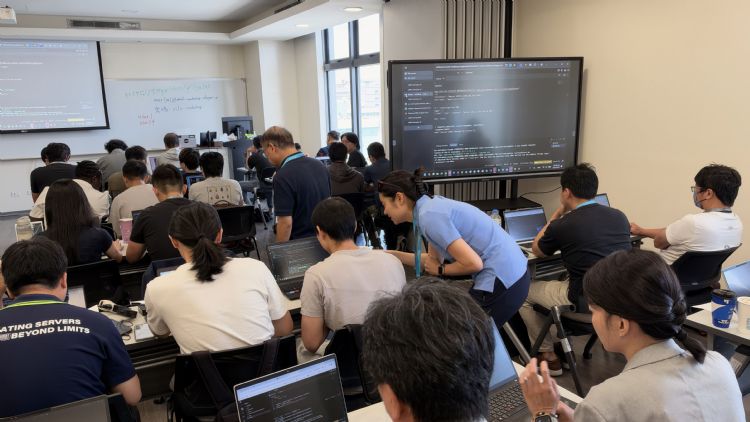
此次AMD Enterprise AI Workshop則將上述架構帶入實際操作。參與者直接連線至AMD建置的環境,操作AIMs與AI Workbench部署及微調模型,並透過Kubernetes了解工作負載與GPU之間的調度機制,再利用Resource Manager管理專案與GPU資源,最後以Solution Blueprints展示如何將模型與推論服務組成實際AI應用。這套由模型部署、底層調度、資源管理到應用建置的流程,也成為此次Workshop的主要脈絡。
企業AI部署複雜度升高 AMD擴充軟體工具鏈
透過AI提升營運效率、加速產品與服務創新,已成為企業數位轉型的重要策略。不過建置AI基礎設施、取得GPU運算資源後,仍須處理模型部署、推論環境建置、使用者權限、GPU資源配置及工作負載監控等軟體整合問題。企業近年積極採購GPU,但如何讓不同團隊有效使用運算資源,同時兼顧效能與管理需求,已成為實際部署時的重要課題。不同產業的需求也有所差異,例如金融業因重視資料安全與延遲,較傾向建置地端GPU叢集;電信業除了支援自身AI工作負載,也可能將自建GPU資源提供客戶使用。
為協助企業降低自行整合軟體堆疊的複雜度,AMD Enterprise AI軟體套件 涵蓋應用建置、模型推論、開發部署及GPU資源管理等環節。其四項主要元件包括AMD Solution Blueprints、AMD推論微服務(AMD Inference Microservices;AIMs)、AMD AI Workbench及AMD Resource Manager。相關軟體以開源方式為主要方向;在實際導入與驗證階段,企業亦可視專案需求,與AMD技術團隊及合作夥伴進行技術評估與部署驗證。
對已建置AI環境的使用者而言,評估GPU平台牽涉的不只是硬體效能與採購成本,既有模型能否持續使用、Kubernetes環境如何銜接,以及資源管理與開發流程需要多少調整,都會影響實際導入成本。因應這類需求,AMD近年持續強化ROCm的效能與軟體生態,並透過AMD Enterprise AI 軟體套件將軟體布局延伸至模型推論、開發部署、GPU資源管理與應用建置,讓既有AI工作流程更容易延續至AMD運算平台,減少部署、調校及軟體轉換所需的工作。
AIMs封裝推論服務 AMD AI Workbench降低部署與微調門檻
模型進入實際部署階段後,企業通常需要自行準備ROCm、vLLM等推論環境,取得模型並建立服務端點,再依硬體與工作負載進行效能調校。AMD推論微服務(AIMs)採容器形式,預先整合模型與推論所需的軟體環境,降低部署過程中的設定工作。目前AIMs目錄涵蓋DeepSeek、GLM、MiniMax、GPT-OSS等模型,企業可依應用需求選擇部署。實際可用模型與版本仍以當時發布的產品目錄為準。
AMD AI Workbench則提供圖形化操作介面,讓使用者選擇AIMs並完成部署,不必直接操作底層Kubernetes指令。此次Workshop實機操作中,參與者可依應用需求選擇優先降低首Token延遲(Time to First Token),或提高整體推論吞吐量,也能調整vLLM相關參數。模型啟動後,Workbench可顯示首Token延遲、Token間延遲及端到端延遲等指標,並呈現GPU記憶體、CPU Core與系統記憶體使用狀況,作為效能測試與部署調整的依據。
AMD AI Workbench也將模型微調納入圖形化流程。使用者可上傳自有資料集、選擇基礎模型及設定相關參數,再以LoRA方式進行微調;完成後,可將原始模型與微調後模型並列,以相同問題比較輸出結果,檢視微調效果。相較自行透過命令列搭配Python、PyTorch等工具建立微調流程,圖形化操作可減少環境設定與操作步驟。
圖形化介面之外,AIMs仍可與既有開發流程串接。模型部署完成後,開發者可取得服務端點,透過Python程式呼叫模型;Workshop也示範利用VS Code連接已部署的AIMs,執行模型呼叫與效能測試。企業若已有自己的應用系統,也可透過服務端點連接AIMs,將模型推論能力納入既有服務。
Kubernetes負責底層調度 串接AI工作負載與GPU資源
AMD AI Workbench與AIMs簡化了使用者看到的模型部署流程,底層的工作負載調度則由Kubernetes負責。企業AI環境中的資料準備、模型訓練、推論及監控,都可透過Kubernetes管理,並處理GPU資源配置、安全隔離、版本更新等工作。對已經使用Kubernetes建置IT環境的企業而言,也可延續既有的容器與資源管理方式部署AI工作負載。
以AIMs部署為例,使用者透過Workbench提出部署需求後,系統會建立對應的Pod,由Pod提出GPU資源需求;AMD Device Plugin則負責辨識各節點可用的GPU資源,讓Kubernetes排程器選擇具備足夠資源的節點,再由kubelet啟動包含AIMs的容器並持續回報執行狀態。當容器失效、Pod數量不足或設定變更時,Kubernetes也會依照預先宣告的目標狀態進行調整,維持工作負載正常運作。
圖形化介面之外,熟悉Kubernetes的開發者仍可透過命令列操作。Workshop現場也示範以YAML定義部署內容,再透過kubectl建立及管理工作負載;企業可依需求採用Kubernetes Deployment、KServe或Docker等方式部署,保留較大的客製與底層控制空間。當多個團隊與工作負載共用同一套GPU基礎設施時,Kubernetes則可透過命名空間(namespace)區隔不同專案,維持資源與權限隔離。
不過,當GPU叢集規模擴大,管理需求也會由單一工作負載的部署與調度,延伸至整體資源的配置與使用狀況。如何設定各專案可使用的GPU數量、掌握資源佔用情形及調整配額,也成為管理者需要處理的問題。
AMD Resource Manager集中管理GPU 掌握專案配額與使用狀況
AMD Resource Manager提供圖形化管理介面,將GPU管理範圍由單一工作負載延伸至專案與整體叢集。透過儀表板,可依叢集、節點、專案及工作負載查看GPU使用狀況,包括使用率、記憶體、溫度、功耗及PCIe流量等資訊。這些資料來自AMD GPU Operator與GPU Driver,並將原本透過AMD SMI或ROCm SMI取得的資訊整合至同一介面,方便集中掌握GPU運作狀態。
除了監控GPU使用情形,Resource Manager也能以專案為單位分配運算資源,包括設定GPU、CPU Core、記憶體及儲存空間配額,以及管理成員與存取權限。模型部署所需的Hugging Face Token、S3儲存憑證等資訊,也可依專案統一管理,讓不同團隊共用GPU基礎設施時,仍能維持各自的資源配置與權限隔離。
面對規模更大的部署環境,Resource Manager可支援連接多個叢集,讓管理者透過同一介面掌握不同叢集的資源狀態。AMD指出,由於多叢集部署涉及網路及基礎設施設定,正式導入前仍須完成相關測試與驗證,再依實際環境規畫管理方式。
AMD Solution Blueprints整合模型與服務 加速AI應用落地
完成模型部署與GPU資源配置後,下一步是結合模型與企業需求,形成可實際使用的AI應用。AMD Solution Blueprints提供預先整合的參考應用,將模型、推論服務及應用程式所需元件組合在一起。目前已有二十多種應用範例,涵蓋醫療、金融服務與電信等垂直市場,包括醫療影像分析、代理式RAG、代理式翻譯、文件摘要、金融詐欺偵測及電信助理等。
AMD Enterprise AI Workshop現場以MRI影像分析Blueprint示範實際部署。開發者可透過Helm Chart將Blueprint部署至Kubernetes,建立應用所需的服務、Pod及AIMs,並依需求調整模型、資料庫及儲存環境。此次示範採用GPT-OSS 20B AIMs作為推論服務,企業也可替換其他模型,或直接呼叫已部署的AIMs,依自身應用需求調整整體架構。
此設計也讓不同應用可以共用既有的AIMs服務,不必為每套應用重複部署模型,減少GPU、CPU與記憶體資源的重複佔用。開發團隊則可將更多工作集中在應用流程與企業資料整合,降低重複建置底層推論環境的工作。因此 AMD Solution Blueprints也成為AMD Enterprise AI 軟體套件中接近應用端的一環,將前述模型部署、GPU調度與資源管理能力延伸至實際AI應用。
後續產品規畫方面,AMD將持續擴大Enterprise AI軟體套件的硬體與模型支援範圍,包括加入AMD Instinct MI350P,並規畫延伸至Ryzen平台;AIMs模型目錄也將持續擴充,除了通用大型語言模型,也將增加生命科學相關模型,涵蓋蛋白質折疊、藥物研發等工作負載,擴大不同運算平台與產業應用的支援範圍。
欲瞭解更多資訊歡迎參閱AMD Enterprise AI Reference Stack與AMD Enterprise AI Documentation。